画像生成の準備で、短い指示をAIに詳しいプロンプトへ書き直してもらう。その待ち時間が気になっていたComfyUIユーザーに、気になる改善が届きました。
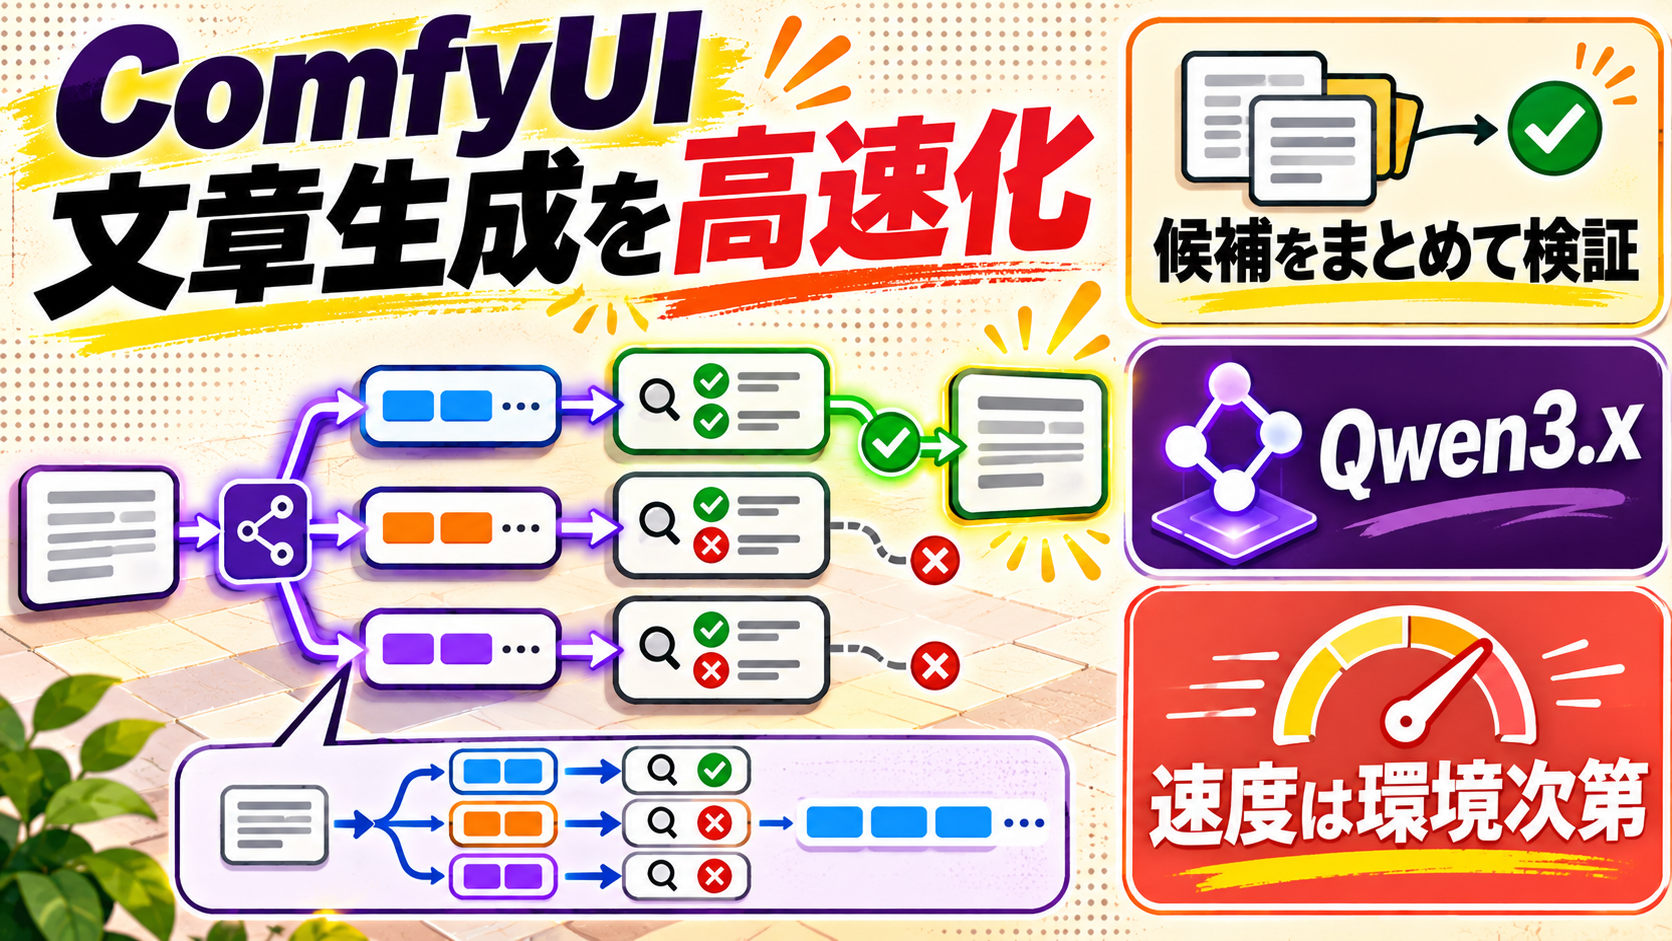
ComfyUIチームは、ローカルで動かすQwen3.x系の文章生成を高速化したと発表しました。同じGPUとモデルを使った公式測定では、2倍を超えた例もあります。速くなったのは画像そのものの生成ではなく、ワークフロー内で使うテキスト生成です。
複数の候補を先読みしてまとめて検証する工夫と、GPUメモリの読み出しを効率化する改善が組み合わされています。
同じGPUでも速度差は一律ではない
ComfyUIの技術解説によると、v0.40.0からv0.45.0への改善で、RTX 5090上のQwen3.5 9Bは毎秒106トークンから219トークンになりました。トークンは文章をモデルが処理する単位です。
一方、同じQwen3.5 9BでもRTX 5080では毎秒91から129トークン。画像を読み取って説明するQwen3.8 27Bでは、RTX 5090上で毎秒55から122トークンという例も示されています。
「2倍」は特定の計測例です。GPUやモデル、入力、出力内容によって伸び方は変わり、画像生成の総所要時間がそのまま半分になるわけではありません。
例えば、画像を作る前に文章を整える工程が長い場合、その部分の待ち時間が減れば、試作を繰り返すテンポがよくなります。逆に画像生成そのものが大部分を占める作業では、全体の短縮幅は小さくなります。
GPUメモリを何度も読む負担を減らす
文章生成では、次のトークンを決めるためにモデルの重みを繰り返し読みます。大きなモデルを一人で動かす場合、計算能力だけでなく、GPUメモリからどれだけ速くデータを読み出せるかが制約になります。
今回の改善では、量子化したモデルの重みをGPUが扱いやすい順序に並べ、読み出しを効率化しました。量子化とは、モデルが使う数値の精度を調整し、必要なメモリや計算量を抑える方法です。
公式が例に挙げるW4A8は、重みを4ビット、活性値を8ビットで扱う形式です。名前だけで画質や回答品質を比較できるものではありません。
メモリに収まるモデルを選ぶ大切さは、以前紹介したローカルAIモデルの記事にも通じます。ただし、モデルの大きさや必要な環境は製品ごとに異なります。
枝分かれした候補をまとめて確かめる
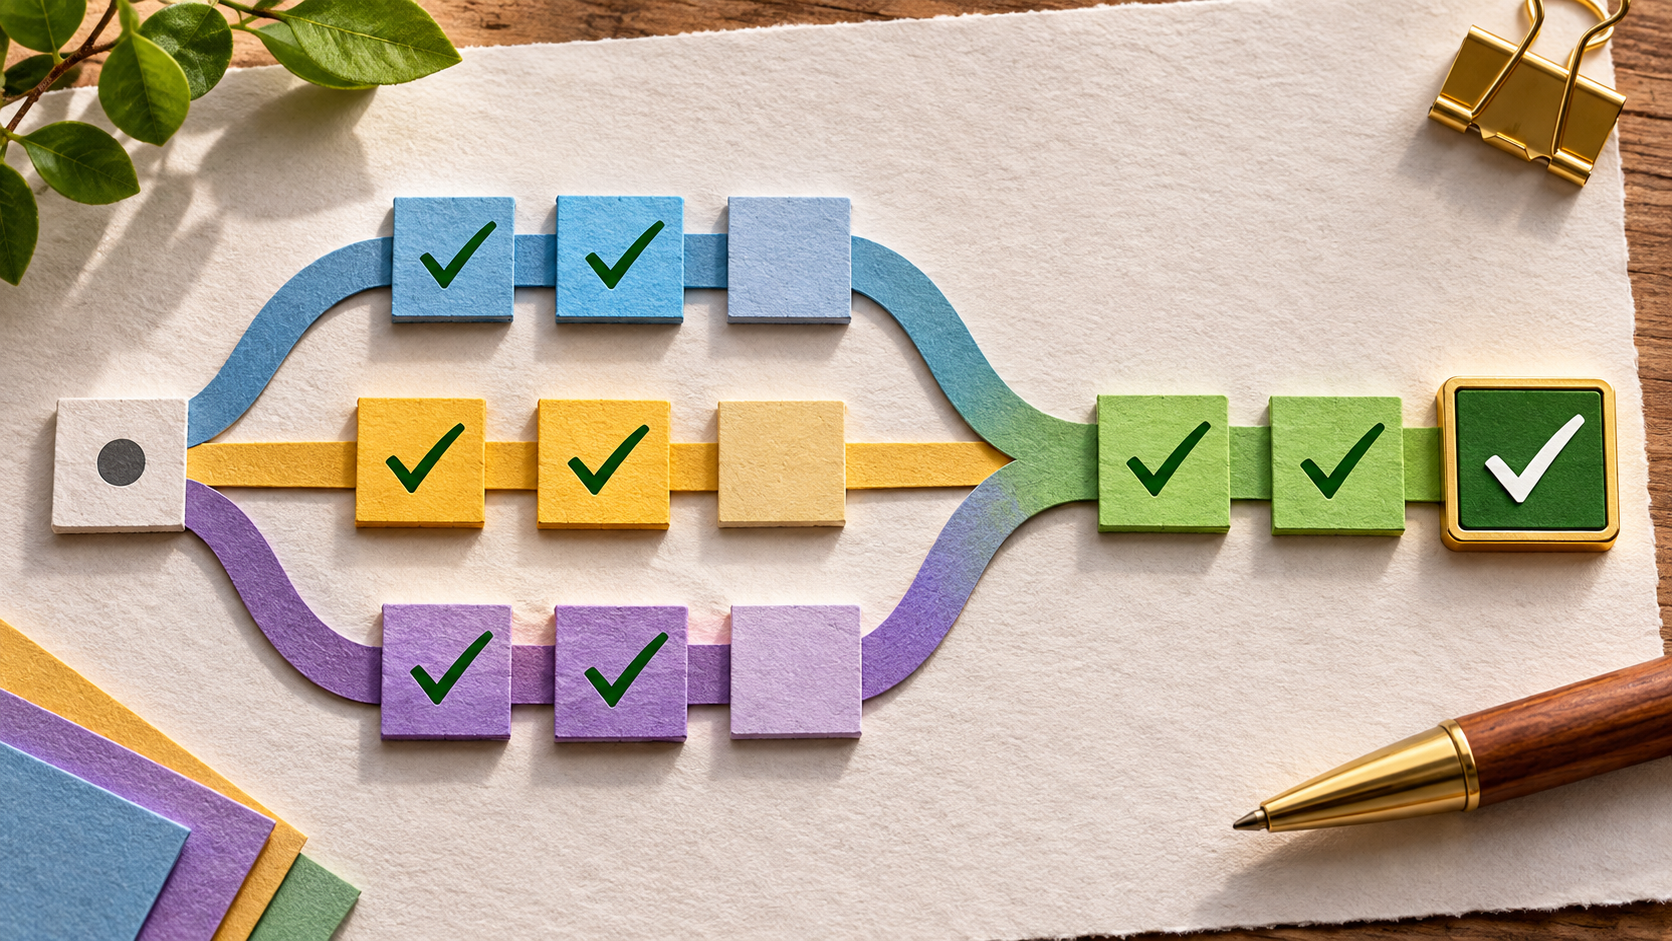
もう一つの主役が、MTP(Multi-token Prediction)を使った先読みです。モデルの小さな追加部分が続きの候補を予測し、本体がそれらをまとめて検証します。合っていた候補を採用できれば、トークンごとに繰り返す処理を減らせます。
以前は候補を一本の道筋として先へ伸ばす方式でした。途中の予測が外れると、それ以降の候補が無駄になりやすいという弱点があります。
新しいツリー方式では、第一候補だけでなく別の候補も枝として残して検証します。文章の性質や当たり方に応じて枝の形を調整するため、一本の予測が外れても別の候補を生かせる場合があります。
先読みは出力を無条件に採用する仕組みではありません。本体の検証を通った候補を使い、外れた候補は捨てます。
どこを設定すれば使える?
公式の案内では、改善はComfyUI v0.45.0で利用できます。Qwen3.xのチェックポイントを読み込み、Generate Textノードの「mtp」を「auto」にして使う流れです。対象はWindowsとLinux上のNVIDIA・AMD GPUと説明されています。
長い入力向けには、追加の高速化手段としてComfyUIの起動時に `--use-ck-attention` を指定する方法も紹介されています。これは別途有効にする選択肢で、すべての改善を使うために必須という意味ではありません。
更新前には既存ワークフローやカスタムノードの互換性を確認し、必要なファイルを保存しておきましょう。対応GPUでも、使うモデルや空きメモリによって結果は変わります。
まず普段使うワークフローで、同じモデル、入力、出力長をそろえて更新前後を比べると、改善が自分の作業にどれだけ効くか見えてきます。AIが整えたプロンプトも、そのまま正しいとは限りません。生成結果を見ながら、人が意図に合う表現へ仕上げていく使い方がよさそうです。

