大事な会話を録音したのに、周囲の雑音や部屋の反響で声が聞き取りにくい。動画や取材の編集で、そんな経験はないでしょうか。
NVIDIAが公開した「NemotronLabs RE-USE」は、音声の劣化を減らすためのAIモデルです。入力した音声を別の音声として出力する仕組みで、文字起こしモデルとは役割が異なります。録音を聞きやすくする可能性がある一方、複数人の声が重なる場面では注意が必要です。
どんな音を対象にし、どのような条件で使えるのか。元の録音を残すべき理由と一緒に見ていきましょう。
RE-USEは音声を音声のまま整える
NVIDIAのモデルカードによると、NemotronLabs RE-USEは約960万パラメーターの音声強調モデルです。雑音や残響、音のひずみ、通信による劣化など、さまざまな条件で傷んだ声の品質を改善することを目指しています。
入力も出力も音声です。声を文章に変える作業ではなく、聞こえる音を処理する段階にあたります。文字起こしが必要なら、処理後の音声を別の音声認識モデルに渡す方法が考えられます。
聞きやすくなった音声が、必ず元の発言を完全に再現しているとは限りません。重要な内容は元の録音とも比べましょう。
雑音だけでなく反響や音の劣化も対象
モデルカードは、周囲から加わる雑音に加えて、部屋の反響、クリッピング、帯域の制限、圧縮やパケット欠落などを対象として挙げています。実際にどの程度改善するかは録音の状態によって変わります。
対応する入力はモノラルのWAV音声で、サンプリング周波数は8、16、22.05、24、32、44.1、48kHzが示されています。元のファイルの形式やチャンネル数を確認してから試すと、処理の前提をつかみやすくなります。
重なった声と笑い声はどうなる?
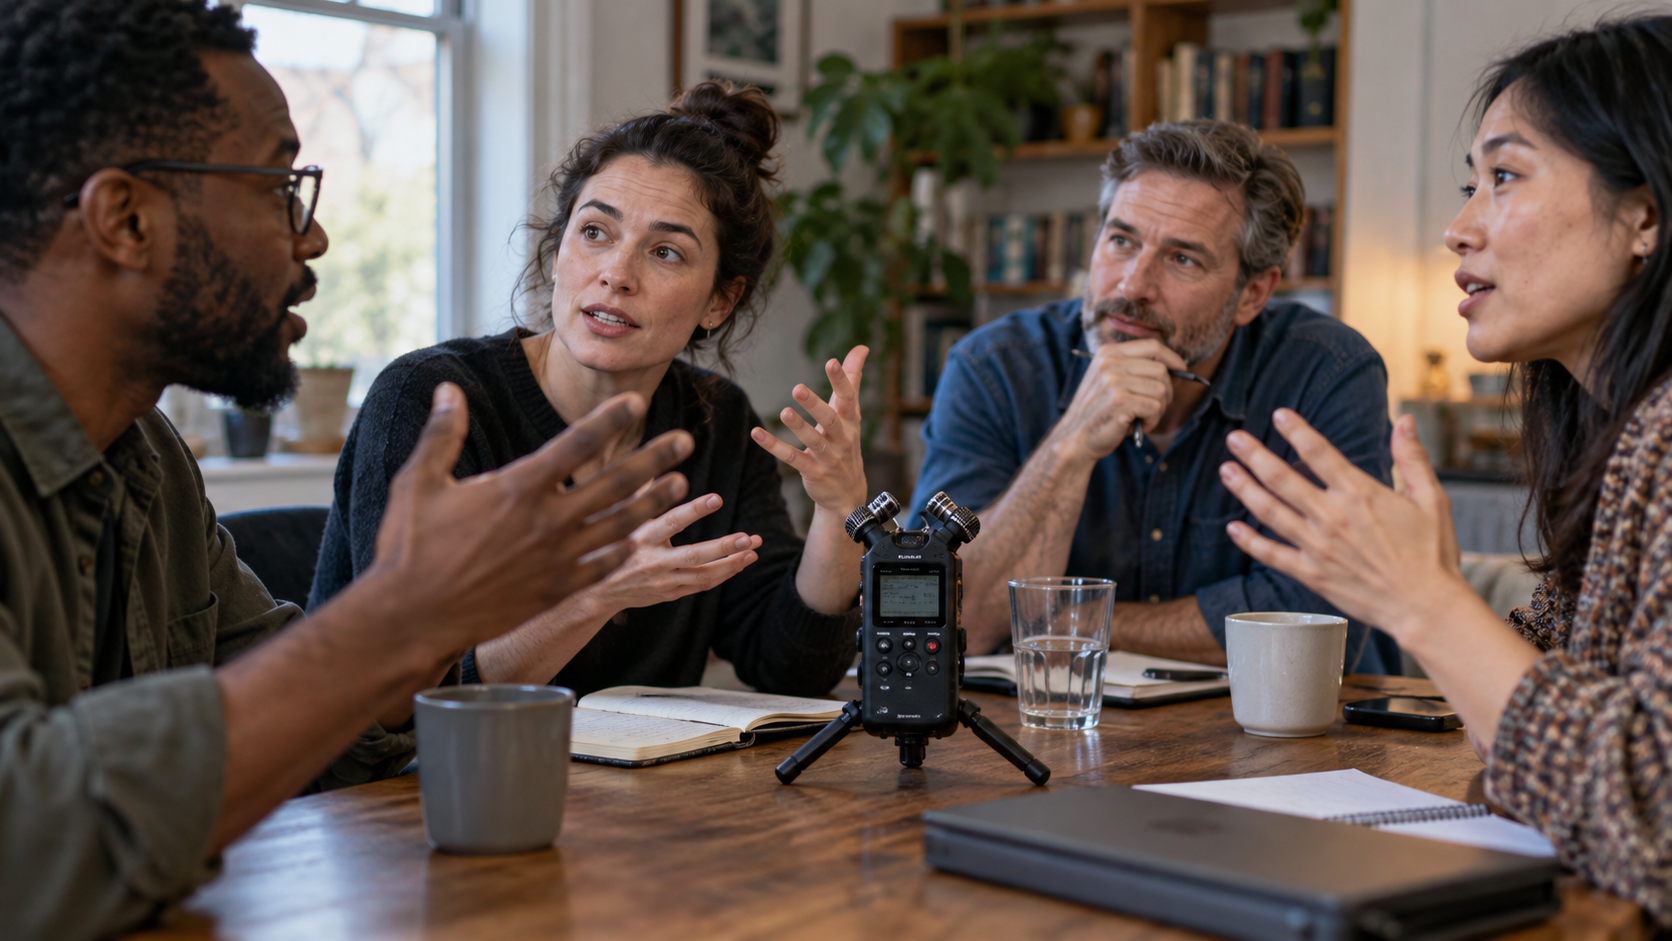
会議の録音では、二人が同時に話すこともあります。NVIDIAは、声が重なった場合に主な話者を残し、それ以外の話者を抑えるよう学習していると説明しています。雑音が減っても、別の人の発言まで小さくなる可能性を考えておきたいところです。
笑い声をより残したい場合には、別のlaughter版が案内されています。会話の雰囲気や複数人の発言が重要な録音なら、目的に合う版を選び、処理前後を聞き比べることが欠かせません。
発言の記録や証拠として使う録音は、処理結果だけに頼らず、変更前のファイルを保管してください。
長い録音と実行環境の選び方
モデルカードには通常の推論方法のほか、長い音声やGPUメモリ不足の場合に、音声を分割して処理する方法が記載されています。長いインタビューや会議では、分割の境界も含めて結果を聞いてみるとよいでしょう。
掲載されている実行環境はLinuxで、ハードウェア要件にはNVIDIA AmpereのA100が記載されています。手元のすべてのPCで同じように動くと考えず、自分の環境との対応を確認する必要があります。
まず短いサンプルを用意し、処理時間と聞こえ方を確認。問題がなければ長い録音へ広げる方法が現実的です。
ブラウザで試せるデモも案内されていますが、録音をアップロードする場合は送信先や利用条件を確認し、機密情報や他人の声の扱いに注意しましょう。
文字起こしとは役割を分けて使う
音を整えるRE-USEに対して、Haas-ja-v1.0は日本語音声を文字にするモデルです。両者は同じ処理ではありません。聞き取りづらい録音を整えてから文字起こしを試すことはできますが、精度が必ず上がるとは限らず、元音声と比べた検証が必要です。
NVIDIAは商用利用可能としていますが、モデルにはOpenMDW 1.1の利用条件があります。配布やサービスへの組み込み前に条件を確認しましょう。
録音の聞きやすさは、内容を振り返るための大切な入口です。RE-USEのような道具を試す際も、元ファイルを残し、必要な声が失われていないか耳で確かめる。そのひと手間が、音声を安心して活用する支えになります。

