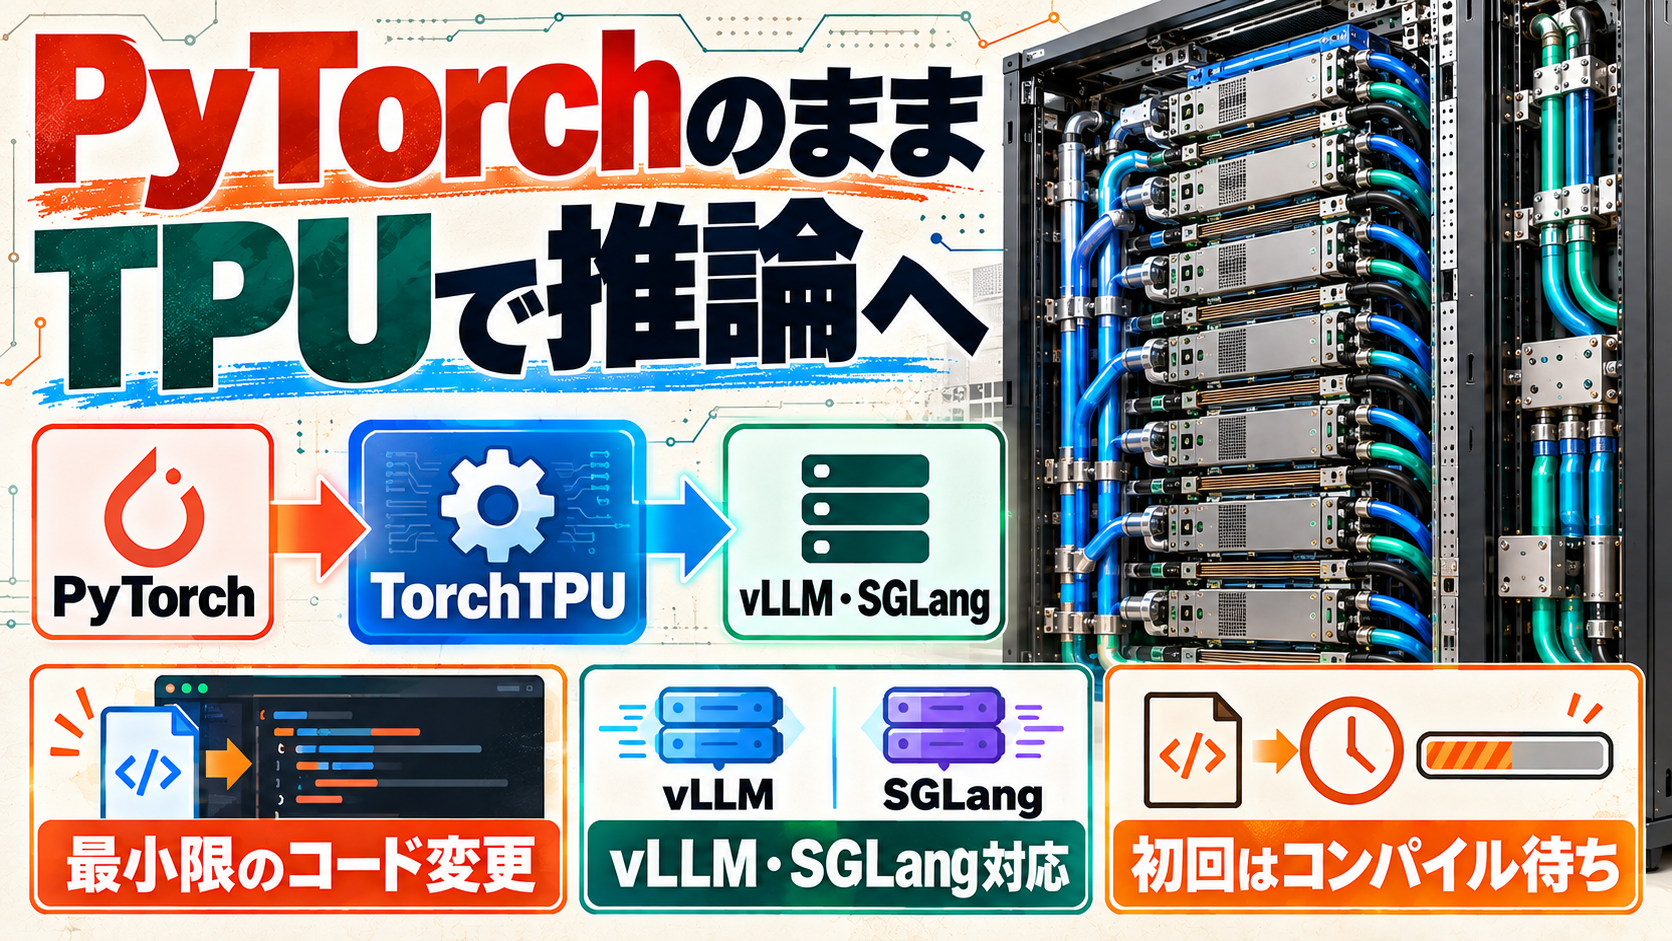
AIの推論環境を作るとき、PyTorchで書いたモデルやvLLMのサーバーを使っていると、ハードウェアの選択はいつの間にかGPU中心になりがちです。そこへGoogleが、PyTorchをTPUでネイティブに動かすためのオープンソース基盤「TorchTPU」を公開しました。
注目点は、新しいチップが出たことだけではありません。すでに使っているPyTorchの操作感を保ちながら、TPUを学習・推論の候補へ加えやすくする狙いです。vLLMやSGLangもTPU向けの新しいバックエンドを公開しており、モデルを動かす場所の考え方が少し変わりそうです。
TorchTPUは「GPUをすぐ置き換える道具」ではなく、PyTorch中心の開発・推論スタックにTPUという選択肢を足す基盤です。
何をそのまま使え、どこで検証が必要になるのかを、推論運用の目線で見ていきます。
TorchTPUで何が公開されたのか
Google Cloudの発表によると、TorchTPUはGoogle TPU上でPyTorchをネイティブに実行するスタックです。GoogleはMetaのPyTorchチームと共同開発し、既存のPyTorchワークロードを最小限のコード変更でTPUへ持ち込めるようにすると説明しています。
ここでいう「ネイティブ」は、TPU向けに別のモデル記述を最初から書き直す話ではありません。使い慣れたPyTorch APIでまず挙動を確かめ、`torch.compile`でTPU利用を最適化する流れを用意することが中心です。GPU、CPU、TPUのどれか一つに環境を固定するのではなく、仕事に合わせて実行先を選ぶための土台と考えると分かりやすいでしょう。
大切なのは、モデルの移植だけではありません。デバッグ、分散実行、サービングまで含む普段の作業経路を、どこまで保てるかがTorchTPUの価値になります。
なぜ「PyTorchのまま」が効くのか
AI基盤では、性能の高いアクセラレーターを選んでも、モデル定義、データ処理、監視、推論サーバーが別の流儀になれば、運用の移行コストは大きくなります。TorchTPUは、PyTorchの標準APIや分散処理の仕組みを使うことで、その差を小さくしようとします。
GoogleはHugging Faceとも連携し、Transformers v5では`device_map="tpu"`でTPUへ配置する経路を案内しています。ただし、これは全てのモデルや周辺ライブラリが無条件に同じ振る舞いをする、という約束ではありません。独自演算、量子化形式、分散構成、入出力の前後処理まで含めれば、実際のコードで試す工程は残ります。
ハードウェアの中身から性能を読みたいなら、openTPUを扱った記事のように、演算器だけでなくメモリーとデータ移動を見る視点も役立ちます。TorchTPUは、その上にあるソフトウェア側のつなぎ目を減らそうとする取り組みです。
まずは小さなモデル、短い入力、既存のテストを一組だけ持ち込む。
出力、レイテンシ、メモリー使用量をGPU環境と並べて確認すると、互換性の問題を大きな移行の前に見つけやすくなります。
vLLM・SGLangをTPUで動かすときの意味
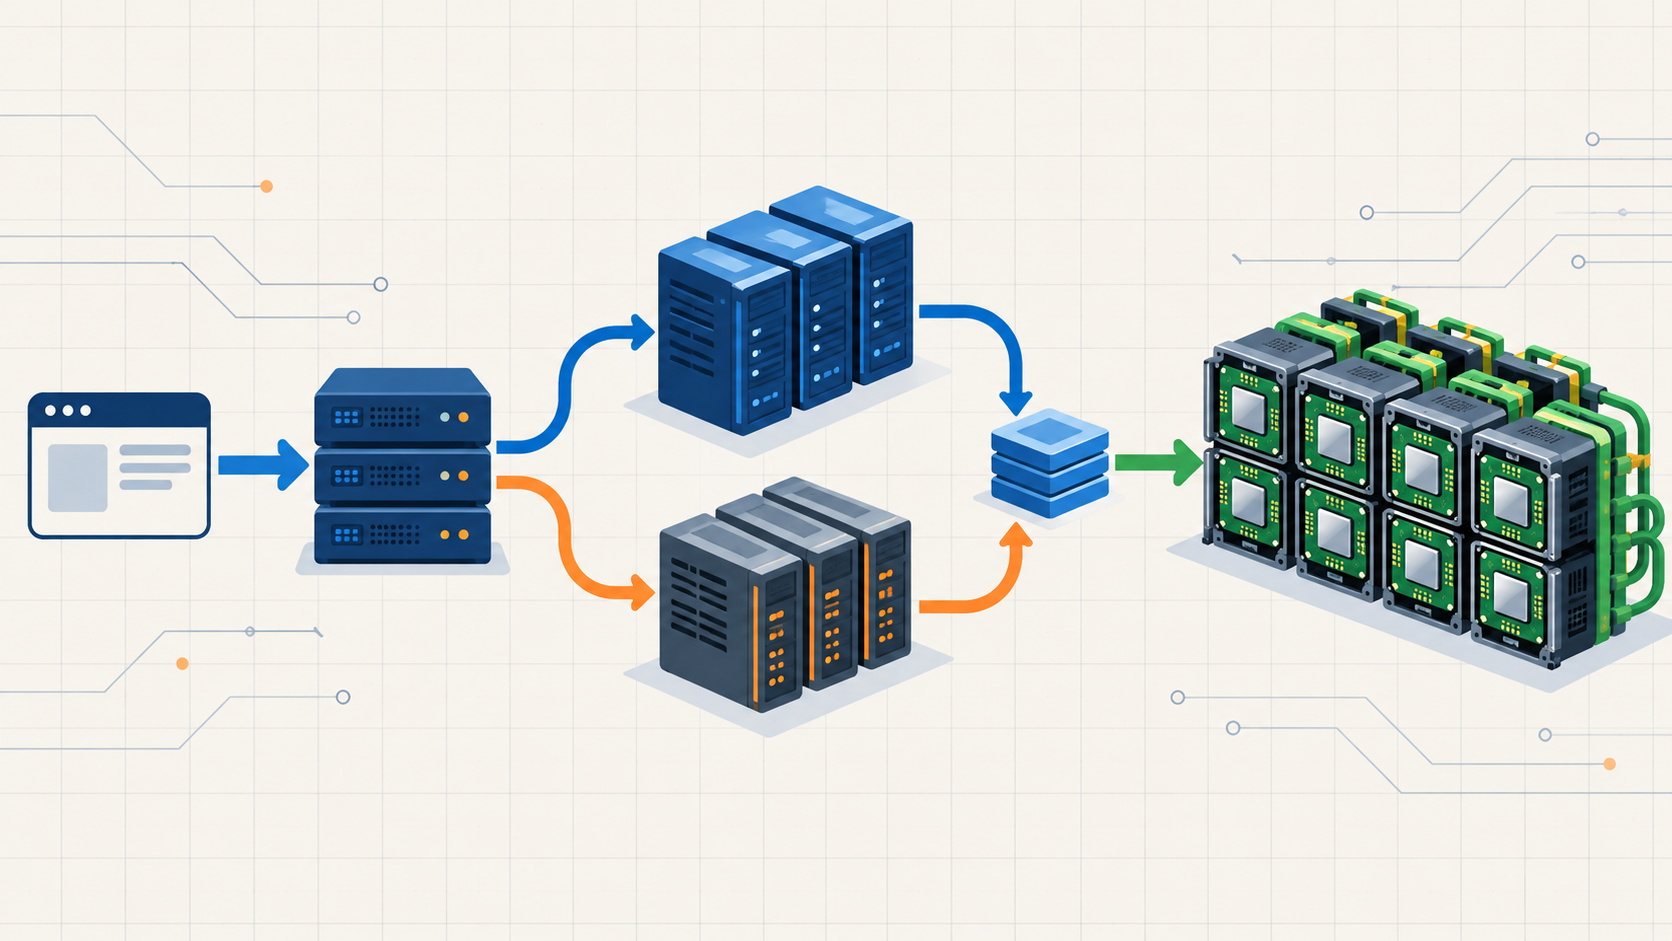
Google Developers Blogは、TorchTPUの上で動くvLLM-TorchTPUとSGLang-TorchTPUを公開しました。どちらも、すでに広く使われる推論エンジンの作法を保ちながら、TPU上で大規模モデルをサーブするための実装です。
vLLM側は、既存のモデルランナー、スケジューラー、KVキャッシュ管理、APIサーバーを保ちつつ、TPU固有の処理を下層へ置く設計を説明しています。SGLang側では、繰り返し使うプロンプトのKVキャッシュを再利用する仕組みも、エージェント型の推論に関わります。
推論基盤の体感は、アクセラレーターの演算性能だけでは決まりません。KVキャッシュ、リクエストの振り分け、ネットワークの待ち方まで重なります。短いRPCをどう待たせないかは、Homaの記事の視点ともつながります。
一方で、対応モデルや最適化の成熟度は実装ごとに異なります。GoogleはQwen、DeepSeek、GLM、Kimi、GPT-OSS、Gemmaなどを挙げていますが、自分のモデル、コンテキスト長、並列数、量子化で必要な機能が揃うかは、導入前に確認が必要です。
すぐに移せるわけではない、三つの確認点
まず実行環境です。vLLMの公式解説では、vLLM-TorchTPUにPython 3.12とCloud TPU VMが必要だと案内されています。普段のGPU用コンテナをそのまま持ち込めるとは限りません。
次に初回起動です。TPU向けにグラフをコンパイルするため、最初の立ち上げには数分かかる場合があります。短い検証で「遅い」と判断せず、ウォームアップ後の応答時間、コンパイル済み成果物の再利用、再起動時の挙動を分けて測ることが重要です。
最後は運用です。監視、負荷試験、障害時の戻し方、GPUとTPUを併用するときのルーティングまで決めて初めて、実行先の選択肢が実用になります。JAXベースのvLLM/SGLang実装も引き続きサポートされるため、既存環境を急いで置き換える理由はありません。
「PyTorch互換」は、性能・コスト・運用が自動で同じになるという意味ではありません。
モデル、入力長、同時実行数、キャッシュ、監視項目を固定した小さな比較から始め、戻せる構成を保ちましょう。
チップ選びを、ソフトウェアの選び直しにしない
TorchTPUが面白いのは、TPUのために開発者が普段の道具を捨てる必要を減らそうとしている点です。PyTorch、vLLM、SGLangという既存の積み重ねを使えれば、ハードウェアの候補を増やすことが、開発基盤を丸ごと作り直す話になりにくくなります。
次に推論環境を広げるなら、「どのチップが速いか」の前に、今のテスト、モデル、サーバー、監視をどこまで持ち運べるかを見てください。
TorchTPUは、その問いにTPU側から答えようとする新しい入口です。

