AIを速く動かすチップといえば、まずGPUや大規模なTPUを思い浮かべるかもしれません。ところが、公開されたばかりのopenTPUは、もっと小さなFPGAカード上で言語モデルを動かし、その設計過程にもAIを使うという、少し変わった実験です。
注目したいのは「AIがチップを設計した」という見出しだけではありません。回路、命令セット、シミュレーター、コンパイラーまでを公開し、実機でどのモデルがどこで待つかを追える形にした点です。AI推論の速さが、演算器の数だけで決まらないことも見えてきます。
openTPUはGPUを置き換える市販製品ではありません。
小さな実機と公開コードで、AIアクセラレーターの中身を端から端まで読めるようにした学習・検証プロジェクトです。だからこそ、推論で本当に詰まる場所を具体的に観察できます。
openTPUは「AI向けチップ」をどこまで公開したのか
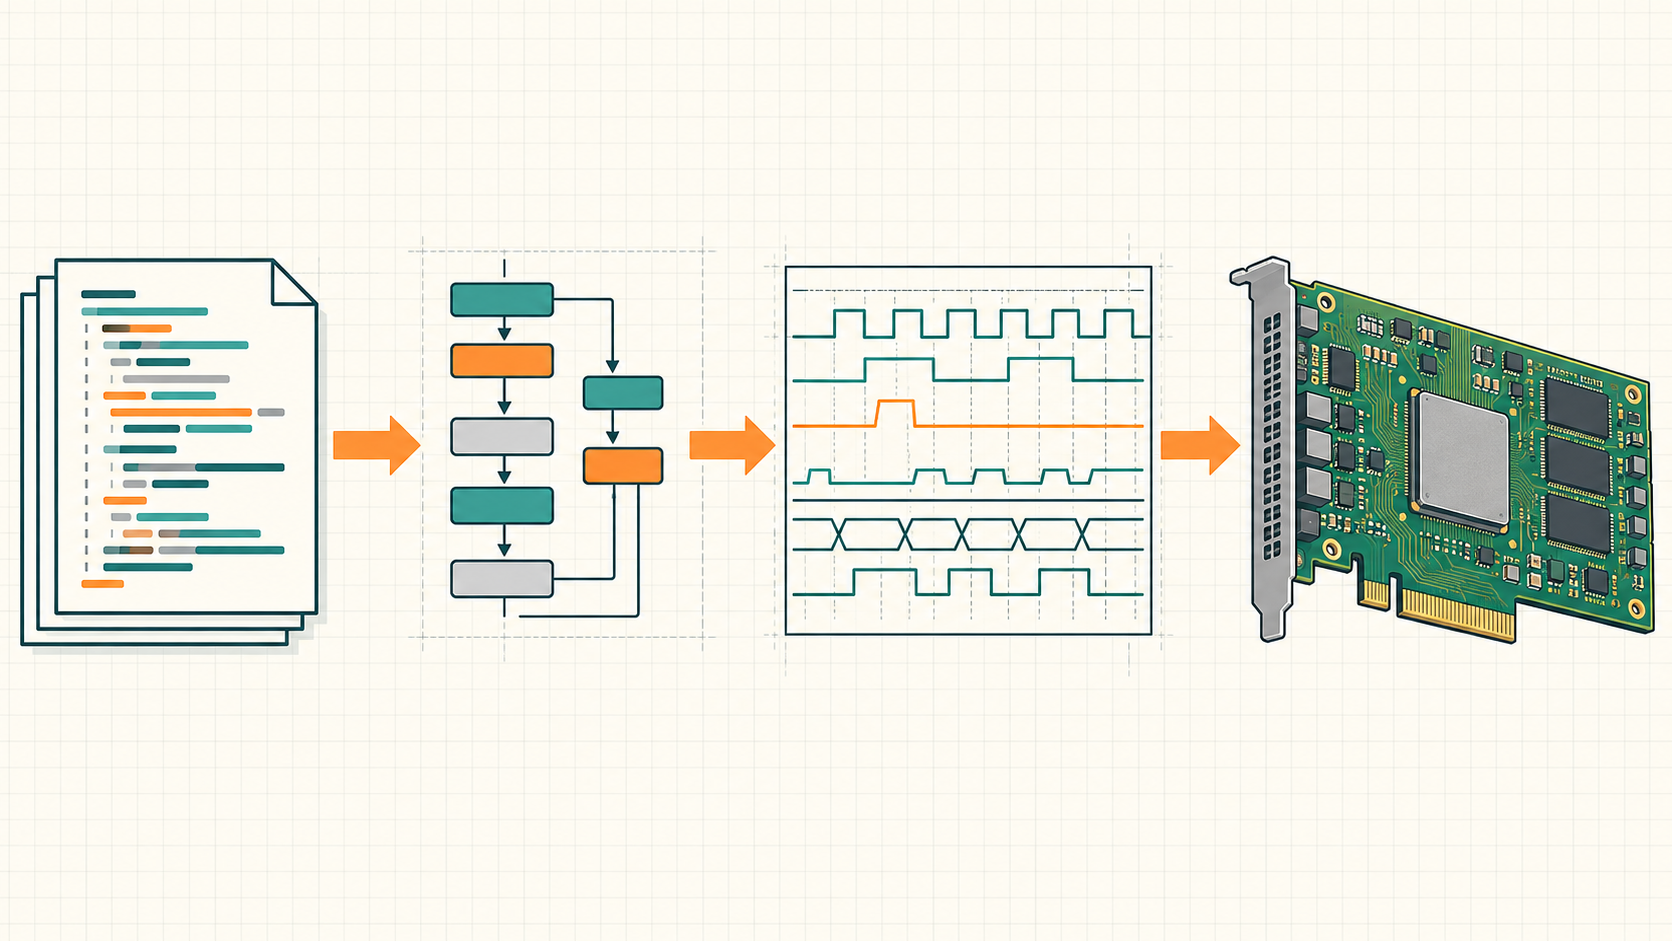
公式リポジトリによると、openTPUはRTL、命令セットアーキテクチャ(ISA)、ビット一致のシミュレーター、カーネル言語とコンパイラー、プロファイラーを一つのリポジトリにまとめています。行列演算を行うユニットだけを見せるのではなく、Python側のカーネルがどんな命令になり、FPGA上でどう動くかまで追える構成です。
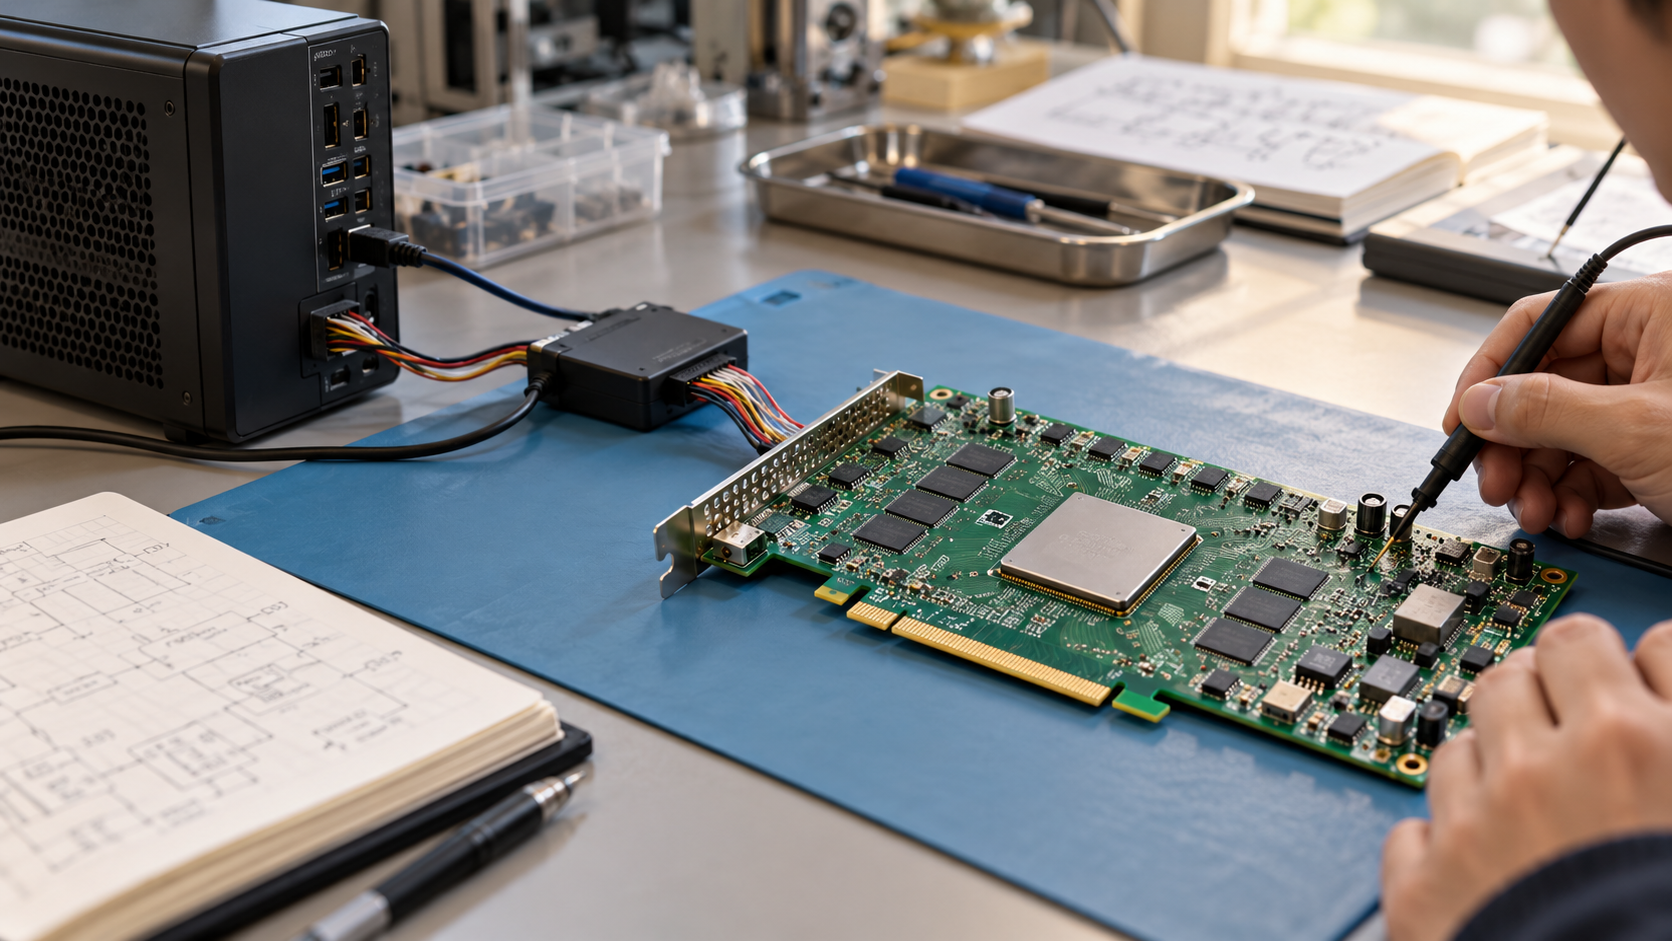
実機にはXilinx Kintex-7を載せたPCIeカードを使います。AIエージェントが関わった設計を公開すること自体がテーマですが、読者にとっての面白さは、完成したチップをブラックボックスとして使うのでなく、演算とデータ移動の両方を読めることにあります。
GPUや専用チップを比べるとき、演算性能の数字だけで結論を急ぎがちです。openTPUのように命令・シミュレーター・実機測定がそろうと、遅さの原因を「なんとなくの性能不足」で終わらせずに考えられます。
小さなFPGAカードで、何が動いている?
openTPUの中心は、命令を一つずつ発行するシーケンサーです。DMAがメモリーからデータを動かし、行列演算ユニットがint8重みを処理し、ベクトルユニットが浮動小数点演算を担います。キャッシュや複雑な自動スケジューリングをあえて持たず、データ移動も命令として見えるようにしています。
この単純さは機能が少ないというより、「何クロックをどこで使ったか」を追いやすくするための設計です。リポジトリは実機とシミュレーターで出力トークンが一致すると説明しており、回路を変えたときに挙動を確かめる土台にもなります。
カードが手元になくても、シミュレーターとテストはノートPCで試せます。一方で実機を動かすには、bitstreamの作成、JTAGでの書き込み、ボードのセットアップが必要です。「すぐ買って挿せる推論カード」とは別の立ち位置だと理解しておきましょう。
実測が教えるのは、演算よりメモリーの待ち時間
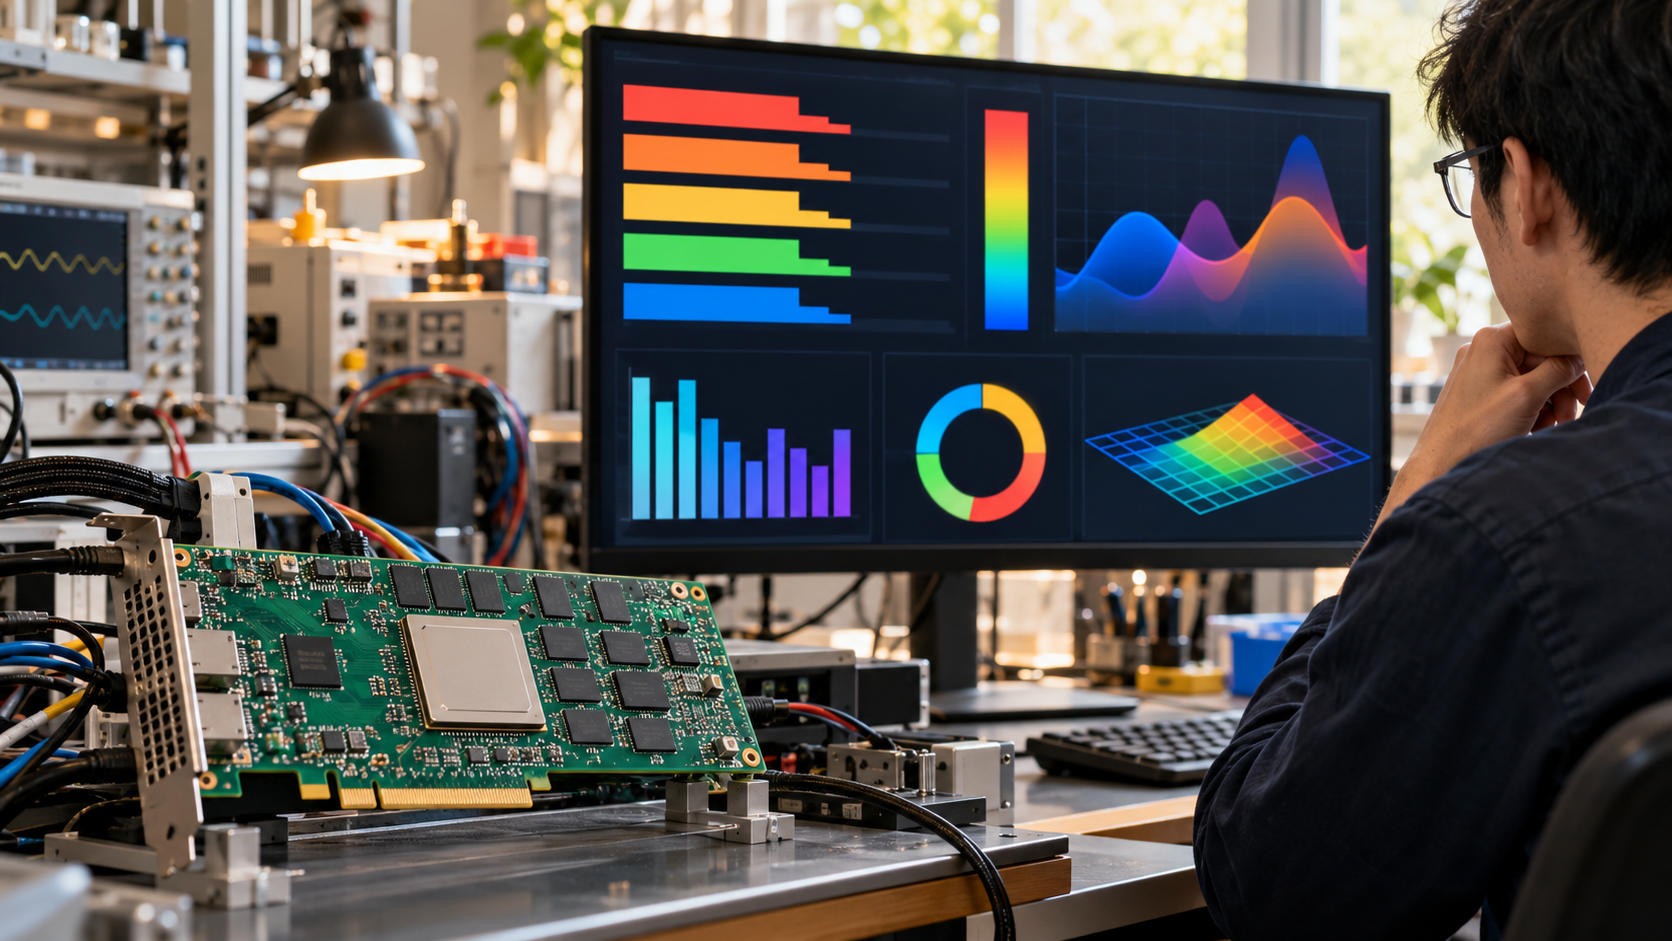
READMEに載る4-bit LFM2.5-230Mのwall decodeは82.1 tok/s、4-bit Qwen3-0.6Bは30.7 tok/sです。数字だけをGPUのベンチマークと横並びにするのは適切ではありません。カード、モデル、量子化、512トークンの入力後に64トークンをgreedy decodeする測定条件が決まっているからです。
それでも大切なのは、開発側がdecodeをDRAM効率に律速される処理だと明記していることです。DDR3-1066のピーク帯域に対して82〜85%を読んでいると説明され、クロックを上げるだけではdecodeが大きく伸びない状況が見えます。
AIサーバーでGPU、DRAM、SSDの関係を整理した[MicronのAIメモリの記事](https://melihat.jp/archives/2072)でも、ボトルネックは一つの部品に固定されません。openTPUはその関係を、より小さなカードで観察できる例です。
大きいモデルは、カードの外からどう呼び込む?
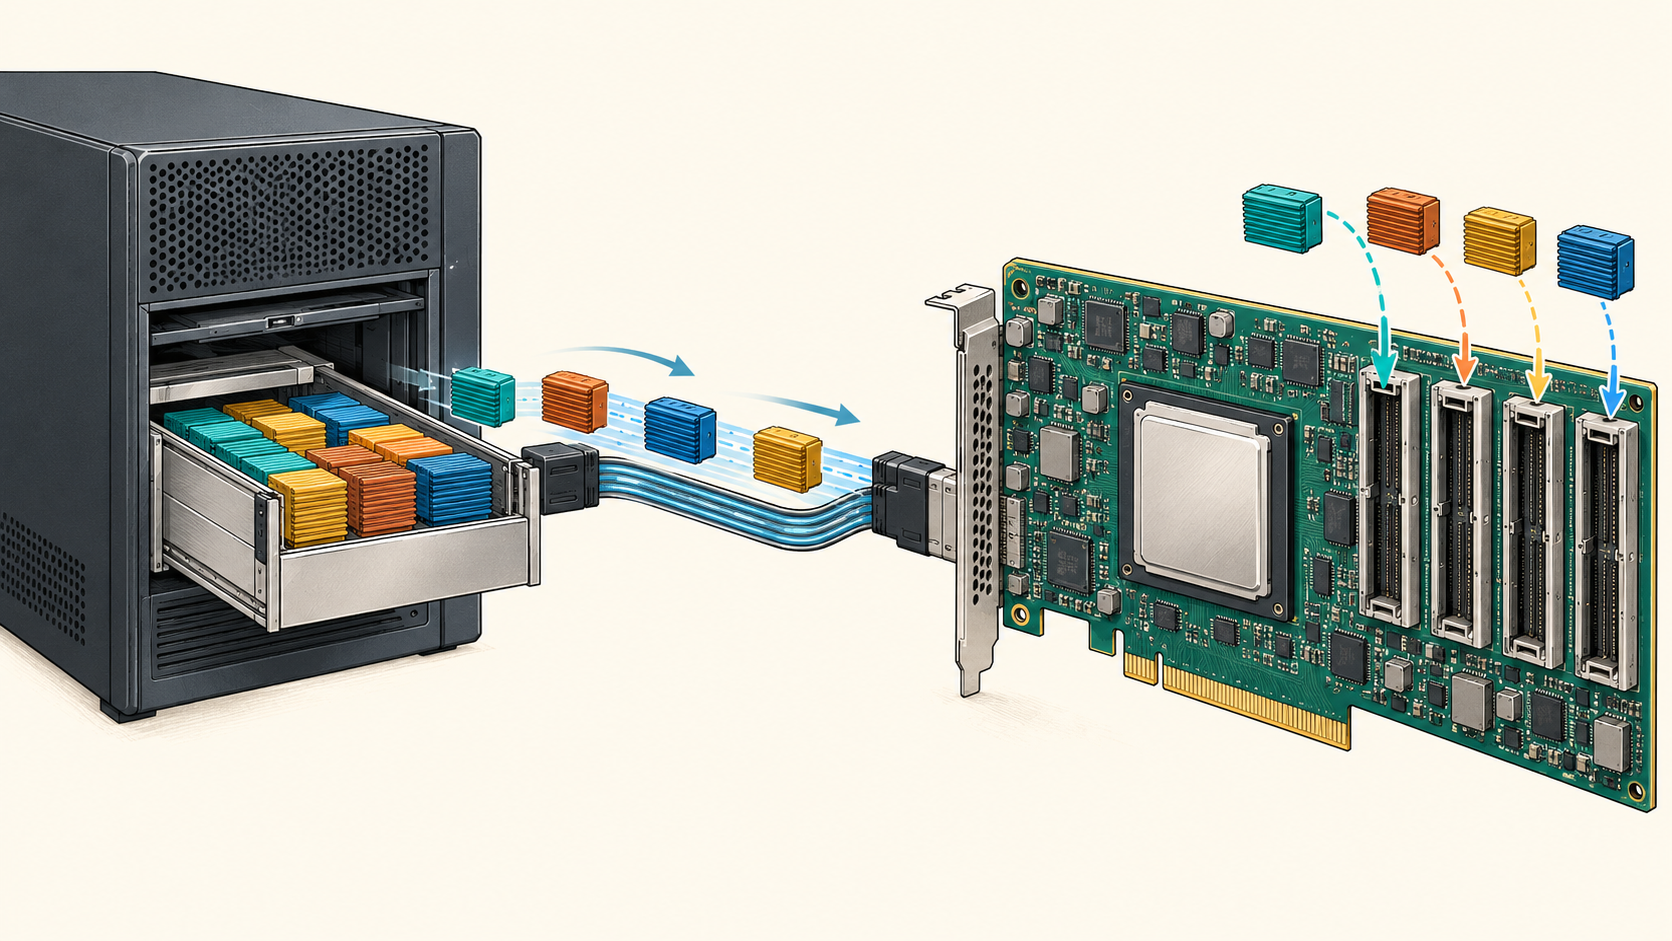
カード上のメモリーは4GiBです。すべての重みを常駐させられないMixture-of-Experts(MoE)モデルでは、必要なexpertをホスト側のプールからPCIe経由で送り込みます。READMEにはQwen3.5-35B-A3Bを4-bitで3.95 tok/sとする測定もありますが、これは「35Bモデルが丸ごとカードに収まる」という意味ではありません。
どの重みを残し、どの重みを移すかで、PCIeとDRAMの待ち方まで変わります。AIクラスタの通信で短い処理を待たせない仕組みを扱ったHomaの記事と同じく、AI基盤は計算器だけでなくデータをいつ、どこから動かすかで体感が変わります。
3.95 tok/sや82.1 tok/sは、openTPU開発者が公開した特定条件での測定です。
市販GPU、Google TPU、別のFPGAで同じ速度になる保証はありません。採用判断では、使うモデル、量子化、入力長、電力、ホストとの接続までそろえて測る必要があります。
「速いチップ」より先に、どこを測るか
openTPUは、AIが回路設計に関われることを示すだけの話ではありません。推論の中で、行列演算、メモリー読み出し、ホストとの受け渡しがどのように絡むかを、小さな実機でほどいて見せるプロジェクトです。
まずはシミュレーターで一つのモデルを動かし、プロファイラーでDRAM待ちと演算の比率を比べる。次に実機へ進むなら、同じプロンプト、同じ量子化、同じ出力長で測る。この順なら、速そうな数字だけを追わずに、AIアクセラレーターが自分の用途で効く場所を見つけやすくなります。
openTPUが示すのは、AI推論の次の工夫が必ずしも巨大な演算器から始まるわけではない、ということです。データ移動を見える化できれば、メモリー帯域や接続経路を改善する余地も、具体的な問題として扱えます。

