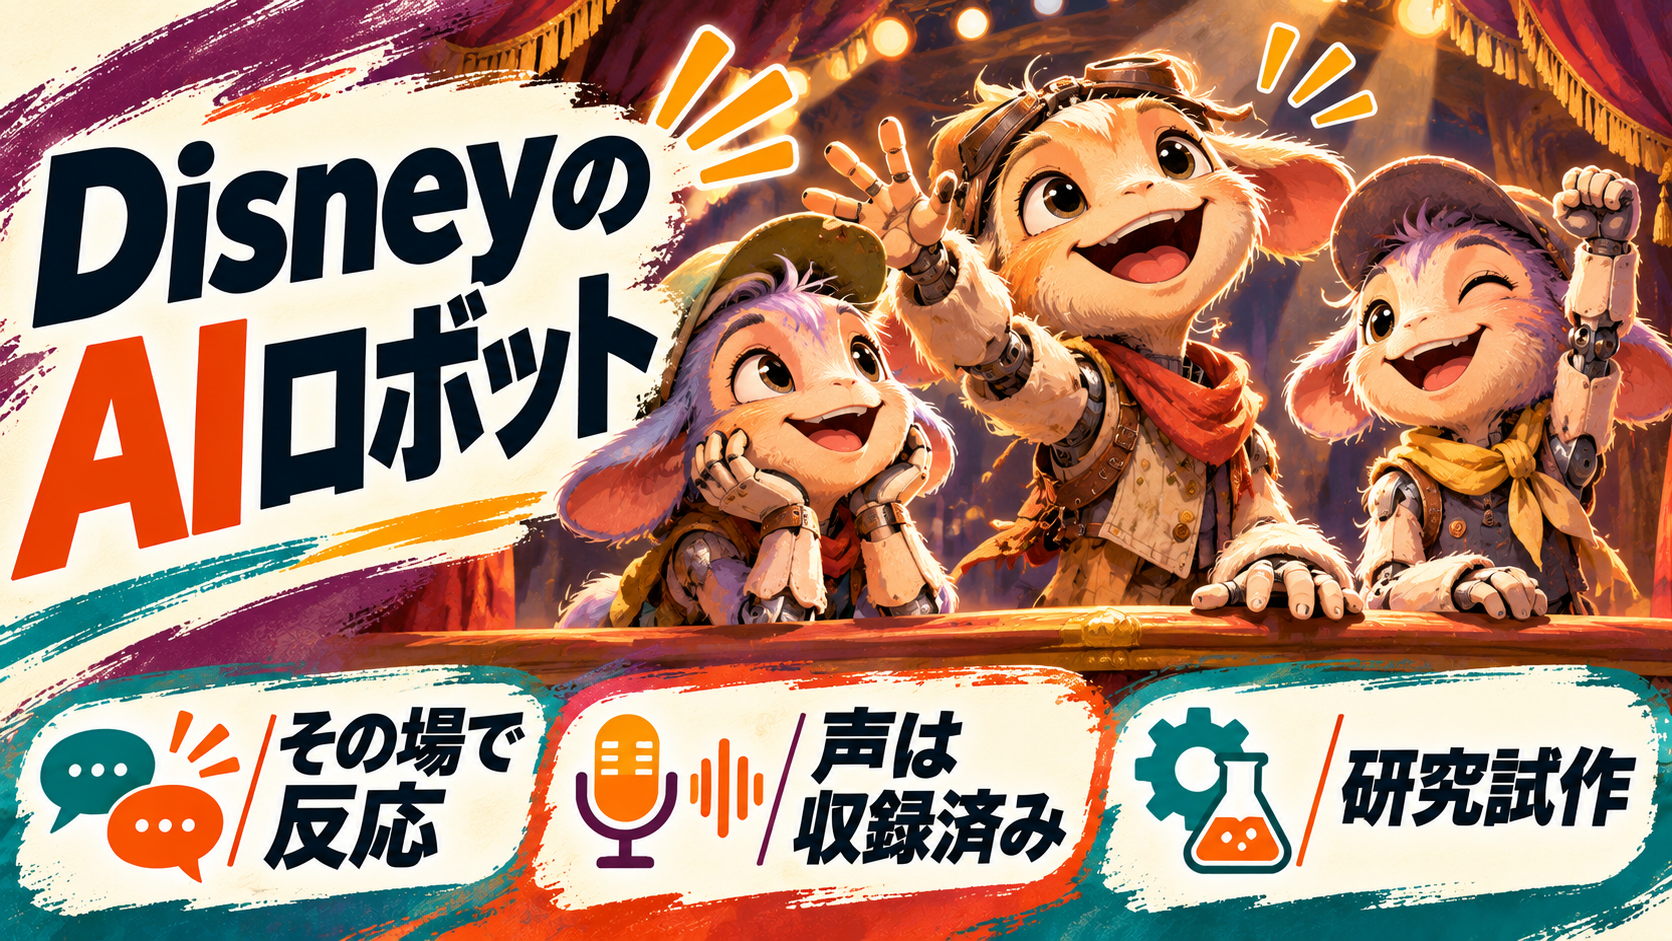
目の前で手を振ると、小さなキャラクターがこちらを向く。隣の仲間にも反応し、毎回少し違うやり取りを見せる――ディズニーがAWSと組んで、そんなロボットの研究試作を披露しました。
「スター・ウォーズ」の世界に登場する種族を題材にした3体のAnzellans(アンゼラン)は、決まった順番の演技を繰り返すだけではありません。一方、話す言葉をその場で何でも生成する仕組みとも限りません。
人が作ったキャラクターらしさと、その場の状況に応じたAIの判断を、どう組み合わせているのでしょうか。
3体が来場者や仲間に応じて動く
ディズニーの発表によると、Vilo Vele、Kado Bre’a、Jibu Bre’aの3体は、Walt Disney Imagineeringの研究開発チームによるAudio-Animatronicsの試作品です。来場者の行動を捉え、互いの様子にも反応するよう設計されています。
従来のショーでは、事前に振り付けられた動きや台詞を決まった順番で再生する演出が中心でした。今回の狙いは、そこにいる人の振る舞いに合わせて反応を選び、その瞬間ならではのやり取りを生むことです。
新しいのは「人が作った演技」を捨てることではなく、状況に応じて演技を選ぶ部分です。
速い判断と大きなモデルを組み合わせる
AWSの発表では、素早い反応を担うモデルと、より大きな文脈を考慮するモデルを使うと説明しています。来場者の動作や声を受け取り、何をするかを判断し、実際の動作へつなげる流れです。
例えば、呼びかけに応じて顔を向ける場面では、反応が遅すぎると会話の自然さが損なわれます。AWSは体験を構成する各部分を遅延に配慮して最適化したとしています。ただし、具体的な応答時間やモデル名は発表されていません。
音声対話でも、発話の内容だけでなく反応の「間」が体験を左右します。日本語音声AIのShizuku-Duplexを紹介した記事も、その違いを考える手がかりになります。
自由な会話生成ではなく、収録した声を選ぶ
ここで注目したいのは音声の作り方です。DisneyとAWSの説明では、システムはあらかじめ収録された音声を選択し、動的なアニメーションと組み合わせて再生します。台詞や性格の細部はImagineeringの制作者が考えたものです。
つまり、AIがその場の状況に合わせて選ぶ余地はあっても、公開情報から「どんな質問にも生成AIが自由に答える」とは言えません。制作者が用意した表現の中で変化を生むことが、キャラクターの一貫性にもつながります。
「自律的に反応する」と「台詞を毎回生成する」は別の話。発表では収録音声の選択が明示されています。
ロボットの賢さは舞台上でどう生きる?
画面の中のチャットと違い、ロボットは視線や動き、声のタイミングで相手に応えます。3体が来場者だけでなく互いにも反応すれば、同じ演目でも会うたびに違う場面を楽しめる可能性があります。
一方で、発表は試作品の紹介です。騒がしい場所での認識精度や、複数の来場者に同時にどう応じるか、取得した情報の取り扱いなど、運用を判断するための詳細は明らかになっていません。人のそばで動く装置として、演出だけでなく運用面も気になるところです。
現時点で一般のパークにいつ導入されるかは発表されていません。試作品の公開と常設アトラクションの決定は分けて考えましょう。
次に会えるのはAWSのイベント
両社は、11月30日から12月4日までラスベガスで開催されるAWS re:InventのCustomer Showcaseで、参加者が3体に会える予定だと案内しています。これはイベントでの展示予定であり、テーマパークでの一般公開日を示すものではありません。
会話をするように見えるキャラクターの裏側では、人が作る物語、AIによる選択、物理的な動作が組み合わされています。Anzellansは、AIを画面の中から現実の体験へ持ち出すとき、速さだけでなく「どんな表現を人が用意するか」も大切になることを示す試作です。

