ローカルAIを試したいと思っても、少し賢いモデルを選ぶとVRAMがすぐ足りなくなります。そこで「24GBに入る74Bモデル」と聞けば、手元のGPUでAIエージェントを動かす現実味が一気に増したように感じるでしょう。NVIDIAが公開したNemotron 3.5 Bolt 74B-A9B 24GBは、まさにその境界を狙ったモデルです。
ただし、74Bという総パラメーターと、24GBというモデルの配置目標だけを結びつけるのは早すぎます。量子化、MoEの有効パラメーター、コンテキスト、実行基盤を分けて見ないと、動くはずの環境で止まったり、期待した速度が出なかったりします。
Nemotron 3.5 Boltのポイントは、74Bモデルを普通の24GB GPUへ無条件に載せる魔法ではありません。
ローカルのAIエージェントで使える知能と、メモリ・速度・実行範囲をどう折り合せるか。そのための圧縮設計として読むと、数字の意味が見えます。
Nemotron 3.5 Boltは、どんなローカルAIモデル?
NVIDIAの技術ページによると、Nemotron 3.5 Bolt 74B-A9B 24GBは、日常的なエージェント作業をRTX/DGX Sparkでローカル実行するために設計されたMoE Hybrid Mamba-Transformerモデルです。総パラメーターは74Bですが、推論時に有効になるのは9B。ウェブ調査、コード作成・修正、ツールを使う作業などを、クラウドへ送らずに扱う用途を想定しています。
重みは公開され、NVIDIAはllama.cpp、Ollama、LM Studio、Unsloth、vLLMでの利用を案内しています。単にチャットを返すモデルではなく、ローカルのフォルダやブラウザ、開発ツールとつなぐ前提だからこそ、何を読ませ、何を実行させるかを先に決める必要があります。
ローカル実行の価値は、API料金を置き換えることだけではありません。入力データ、実行ログ、接続するツールの範囲を自分で決められることにあります。
74Bを24GBへ、どう圧縮している?
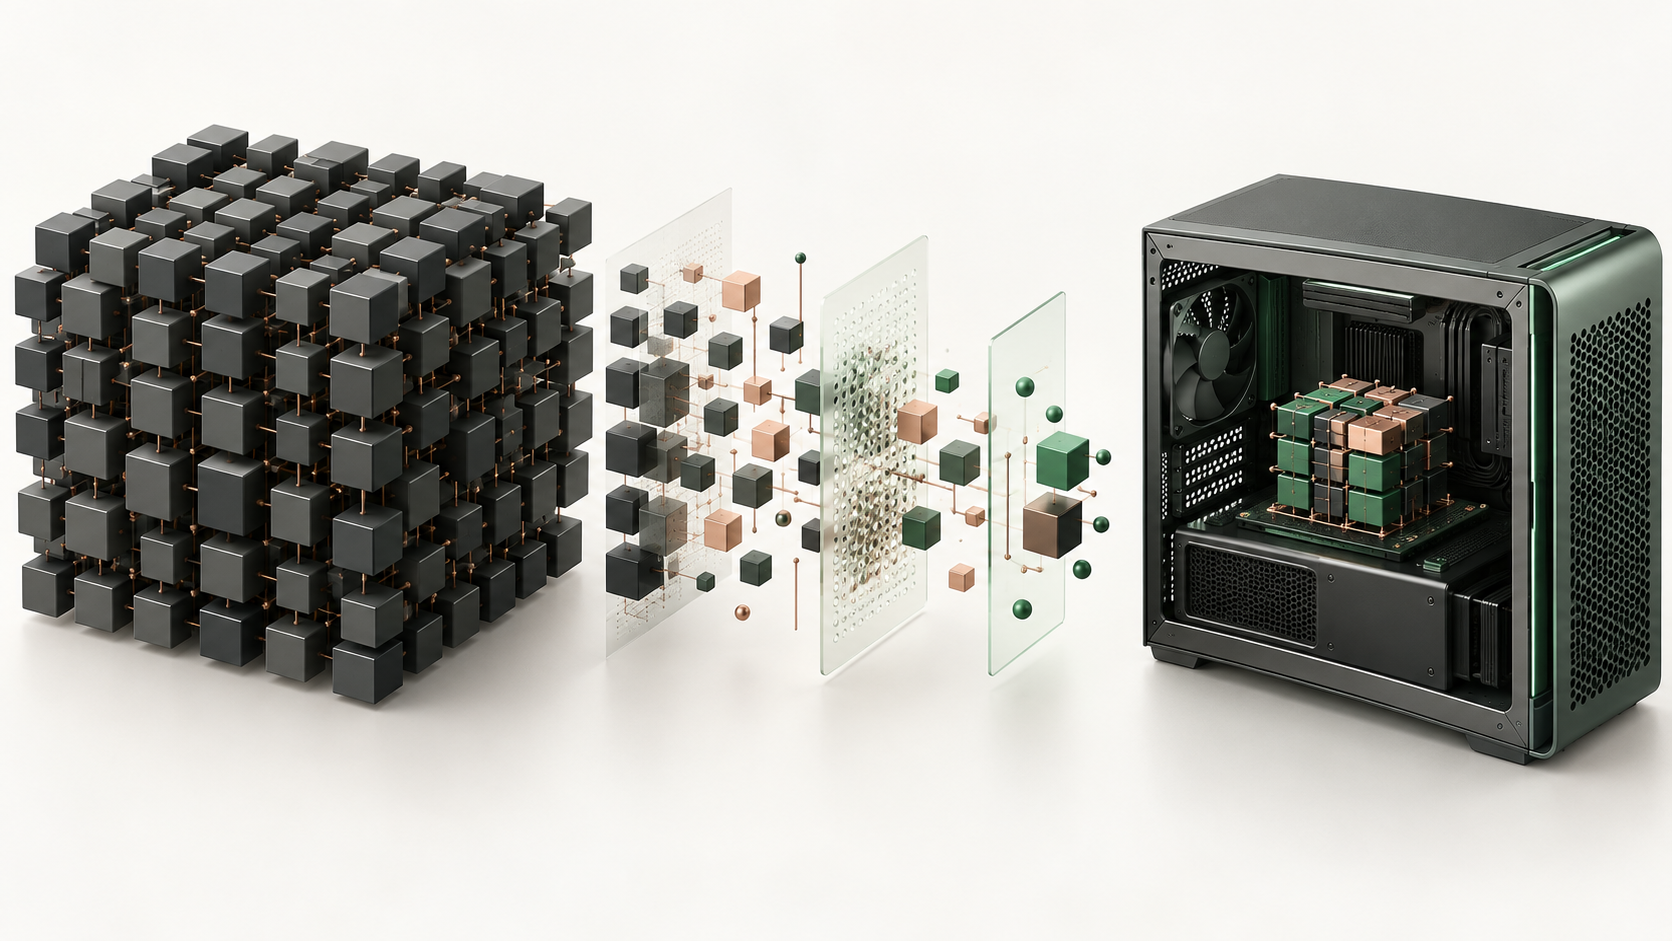
親になるNemotron 3.5 Super VLは120B総パラメーター・12B activeで、Boltはそこから74B・9B activeへ圧縮されています。NVIDIAは、まずStar Elasticで専門家の数や幅を探し、追加学習で機能を戻し、さらに主なexpert層を1要素あたり2.0625ビットの形式まで量子化したと説明します。
ここで大切なのは「全てを単純に2ビットへ落とした」という話ではないことです。層によって別の形式を使い、量子化対応蒸留も組み合わせています。大きいモデルをそのまま縮めるのではなく、どの部分を残し、どこを軽くするかを設計して、24GBの実行枠へ合わせる考え方です。
74Bはモデル全体、9B activeは1トークンで主に動く部分、24GBはモデルを収める設計目標です。
同じ数字の単位に見えても、計算量、重みの配置、実運用の必要メモリを表すものは違います。
「24GBに収まる」なら、すぐ使える?
NVIDIAは24GBに収め、RTX Spark上で少なくとも80 TPSを狙う設計としています。技術ページには、Windows 11 ARM x64、Surface Laptop Ultra、128GBのRTX Sparkで、AIPerf SPEED-Bench-Codingが83.99 TPSだったという測定もあります。これは有望な目安ですが、同じ速度を任意のPCで再現する数字ではありません。
OSや実行基盤の領域、長い会話で増えるKVキャッシュ、同時に動かすアプリ、コンテキスト長で必要量は変わります。24GBという表示だけで、手元のGPU、ドライバー、量子化形式、ランタイムが揃うとは限りません。ローカルAI向けPCでメモリ帯域を読む視点のように、容量だけでなく、どの形式をどの速度で読み出すかまで確認したいところです。
最初の検証は、短い指示を一人で実行するところから始めるのが安全です。長い履歴、複数ツール、複数ユーザーを一度に足すと、メモリ不足と応答遅延の原因を分けにくくなります。
ローカルエージェントに、何を任せる?
モデルを手元で動かせるからといって、PCの全ファイルや外部サービスを渡す必要はありません。コードの検索、決めた作業フォルダの修正、テスト結果の要約のように、戻しやすく影響が小さい範囲から始める方が、モデルとツールの両方を評価しやすくなります。
特にエージェントは、回答だけでなくファイル操作やコマンド実行へ進みます。量子化でモデルが軽くなっても、誤った削除、意図しない外部送信、権限外の操作まで軽くなるわけではありません。AIエージェントの権限をどこで止めるかを扱った記事と同じく、対象フォルダ、許可する操作、人が確認する地点を先に決めることが重要です。
ローカル実行は、安全設定を省略できる理由にはなりません。
原本は複製し、書き込み先を絞り、外部への通信と破壊的なコマンドは別の確認経路へ置きましょう。
速さの数字より、次の作業が続くかを見る
Nemotron 3.5 Boltは、モデルを大きくする競争だけでなく、限られたメモリでエージェント作業を続けるための工夫を示します。74Bから9B activeへ、さらに量子化と投機的デコーディングを組み合わせたのは、1回だけ短い答えを返すためではなく、ローカルでツールを使う仕事まで視野に入れた設計です。
24GBという数字は、ローカルAIの入口を広げます。
ただし評価すべきなのは、ベンチマークの最速値だけではありません。自分のGPU、入力の長さ、任せる操作、止める手順で、エージェントが最後まで扱えるかを小さく確かめる。それがNemotron 3.5 Boltを実用へ近づける一歩になります。

