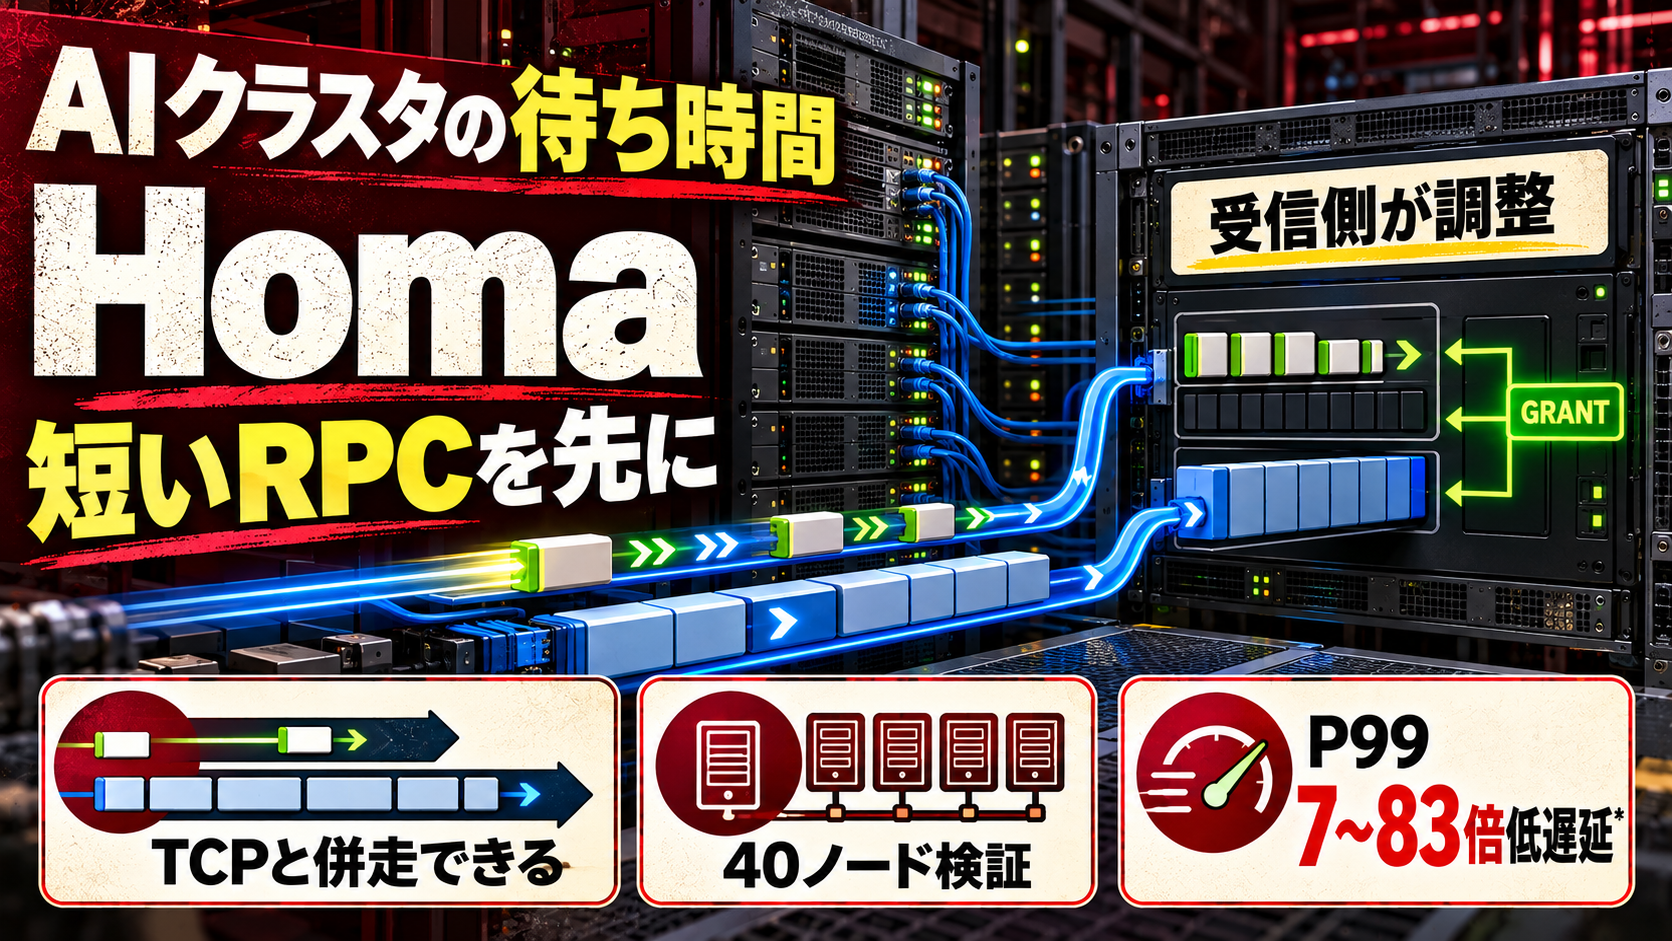
AIクラスタでは、巨大なモデルのデータを運ぶ通信と、小さなRPCを返す通信が同じネットワークを通ります。短い返答が大きな転送の後ろに並ぶと、GPUが次の仕事を待つ時間まで伸びかねません。そこで改めて注目したいのが、データセンター向けトランスポートプロトコルのHomaです。
HomaはTCPを今すぐ置き換えるための魔法ではありません。けれども、「短い処理要求を、長いデータ転送に埋もれさせない」という問題を、送信側ではなく受信側から組み直します。AI基盤の速度を考えるとき、GPUやメモリの次にネットワークの待ち方まで見えてきます。
Homaの焦点は、回線速度の数字だけではありません。
AIクラスタで頻発する小さなRPCを、混雑した経路のどこで先に通すか。通信の順番を受信側が調整することで、待ち時間の長い裾を縮めようとする設計です。
Homaは何を変えようとしているのか
Homaは、データセンター内のRPC向けに設計されたトランスポートです。ウェブブラウザで使うTCPをそのまま否定するのではなく、短いメッセージと長いメッセージが混ざる環境で、短い方が後ろへ押し出される問題を小さくすることを狙います。
AIクラスタでは、モデルの重みや勾配のような大きな転送だけでなく、KVキャッシュの問い合わせや制御情報のような小さな往復も発生します。小さな要求の返答が遅れると、計算資源が次の段階へ進めません。Homaが対象にするのは、まさにこの「短い往復の待ち」です。
重要なのは、Homaが一般のインターネット向け通信を丸ごと置き換える話ではないことです。狙いは遅延に厳しいデータセンター内のRPCであり、用途を絞って設計されています。
受信側がGRANTを出すと、何が変わる?
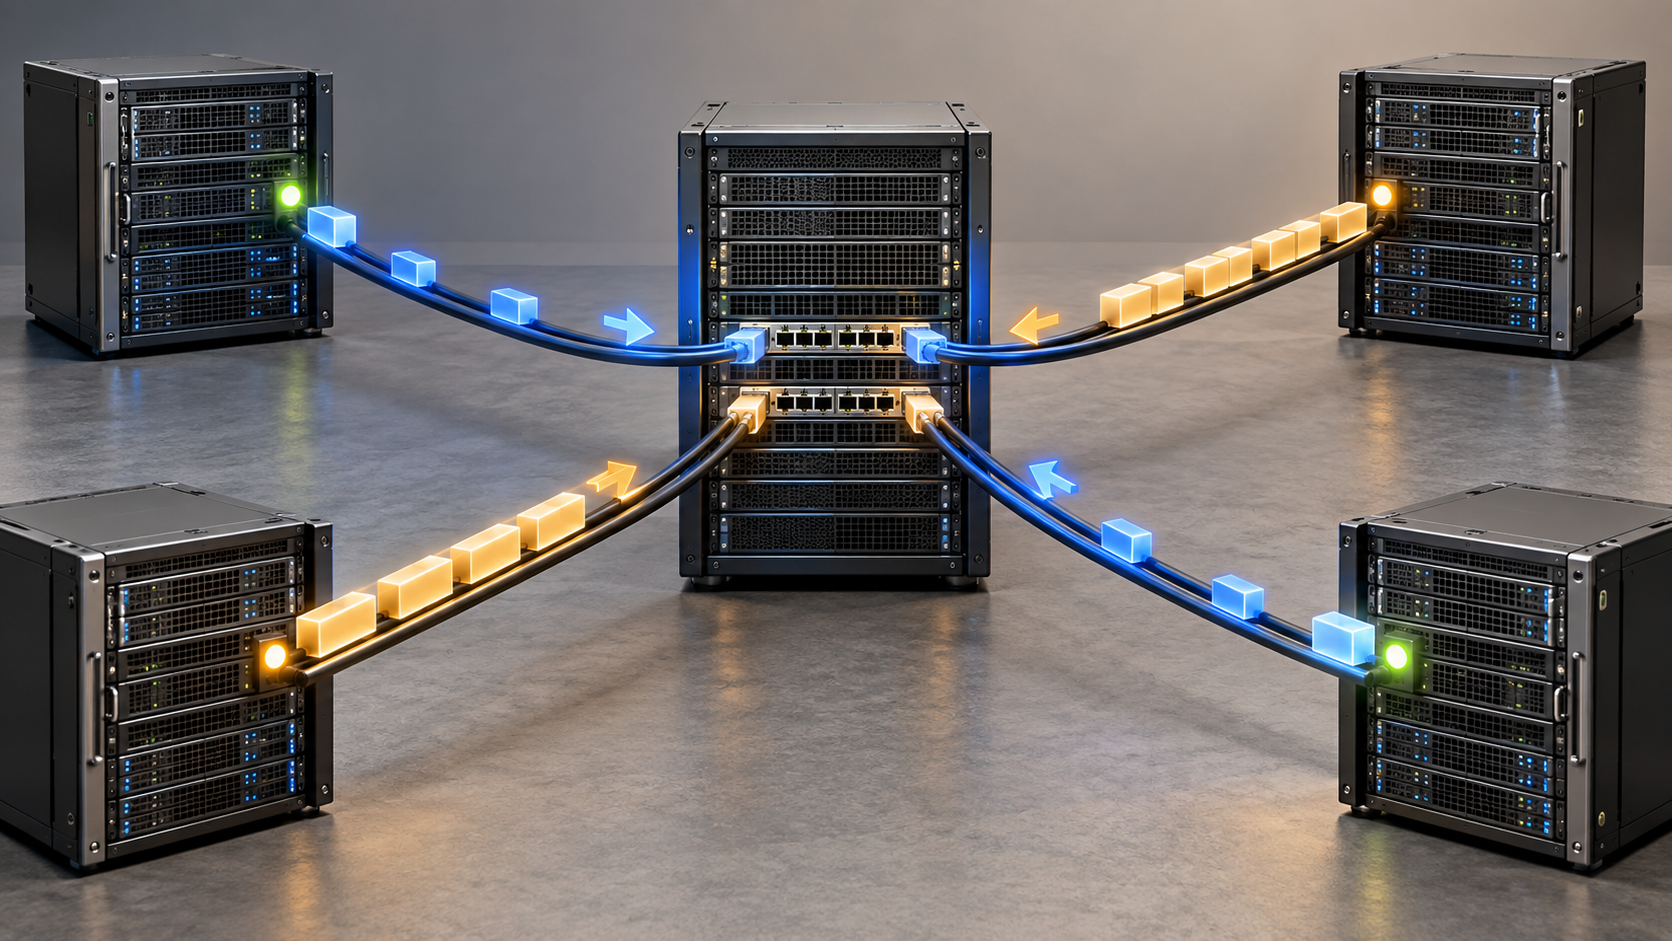
TCPでは、送信側が混雑を推測しながら送る量を調整します。対してHomaは、受信側が到着予定のメッセージを見て、次にどの送信者へ送信を許すかをGRANTで決める方式です。受信側から見れば、複数の送信者が同時に押し寄せたときの順番をまとめて扱えます。
さらにHomaは、残りが短いメッセージを優先する考え方を取り入れています。大きな転送を止めてしまうためではなく、小さな要求を長い列の後ろで待たせないためです。TCPのストリームで起きやすい、長いデータの後ろに短い応答が詰まる状態を避けることが中心にあります。
2021年のUSENIX論文では、40ノードのクラスタベンチマークで、短いメッセージのP99遅延がTCP/DCTCPより7〜83倍低かったと報告されています。ただし、これは条件をそろえた研究結果です。自社のネットワークでも同じ差が出る、と読み替えるのは早すぎます。
導入を考えるなら、平均遅延だけでなくP99のような遅い側の待ち時間を分けて見るのが出発点です。AI処理の停止感は、平均値より「たまに長く止まる」場面で表れやすいためです。
Linux実装は、どこまで進んでいる?
HomaにはLinuxカーネルモジュールの公開実装があります。リポジトリでは、2026年にRHEL 8/9.5へのバックポート、TCPと同時に流す際の性能を調整する`homa_qdisc`、GRANT機構の更新が記録されています。少なくとも「論文だけのアイデア」ではなく、実装を動かして評価する土台は公開されています。
一方で、既存アプリを設定一つでHomaへ切り替えられるわけではありません。公開実装はTCPソケットと異なるAPIを持ち、カーネル本体への取り込みも段階的に進むと説明されています。IANAがIPプロトコル番号146を割り当てていることも前進ですが、互換性の問題が消えたという意味ではありません。
つまり評価の入口は、「TCPより速いか」を一つの数字で比べることではありません。アプリがRPCの完了をどう待つのか、既存のライブラリがどのソケットAPIを前提にしているのか、NICとカーネルの組み合わせで再現性が保てるのかまで確認が必要です。Homaのような低レイヤーの仕組みは、アプリのコードが変わらなく見えても、観測・障害対応・ロールバックの準備まで含めて初めて運用できます。
いきなり本番のAIクラスタへ入れないことが大切です。
NIC、カーネル、RPCフレームワーク、監視方法まで関係するため、まずは再現可能な検証環境で、TCP併走時を含めて確認したいところです。
AIサーバーの性能は、GPU単体では決まりません。メモリやSSDまで含めた基盤の見方は、こちらの記事も参考になります。
AIクラスタで試すなら、先に決めたい観測項目
Homaを評価する目的は、ベンチマークの良い数字を再現することではありません。自分たちのワークロードで、どの種類の通信が詰まり、どの待ち時間がアプリの処理を止めているのかを確かめることです。
たとえば、短いRPCと大容量転送の比率、P50/P95/P99の遅延、送信者が集中したときの落ち方、CPUコア使用率、再送やタイムアウトを分けて記録します。Homaの論文も、ネットワーク混雑だけでなく、カーネル処理などのソフトウェアオーバーヘッドが制約になり得ると示しています。
ここで役立つのは、比較条件を意図的にそろえることです。メッセージサイズ、同時接続数、ネットワーク負荷、CPUの割り当てを変えずに、TCPだけのときと併走時を順に測る。速くなった経路だけを見るのではなく、遅くなった通信や運用上の扱いにくさがないかも残します。そうすると、Homaが本当に効く場所と、従来のTCPで十分な場所を混同しません。
結果を共有するときは、平均値と最良値だけを掲げず、測定時間、負荷の作り方、外れ値の扱いも添えます。小さな改善が、実際の利用者操作や学習ジョブの待ち時間にどれだけ結び付いたのかまで追うと、次の投資判断がしやすくなります。
ローカルでアプリのつながりを試す段階と、実際のクラスタ通信を測る段階も混ぜないほうが安全です。前者を素早く回したいなら、AWSサービスをローカルで再現するMiniStackの記事が役に立ちます。
Homaを試す対象は、最初から全トラフィックでなくて構いません。遅いRPCが明確に見えている一つの経路を選び、TCPと並べて観測できる範囲から始めると、効果と副作用を切り分けやすくなります。
GPUを増やす前に、待ち行列の形も見る
AIインフラでは、GPU、メモリ、ストレージの強化が目を引きます。しかし、計算を待たせる通信の順番まで設計しなければ、速い部品を増やしても体感の遅れが残ることがあります。Homaは、その通信の順番を受信側から扱うための、実装も公開された選択肢の一つです。
すぐにTCPを捨てる必要はありません。短いRPCがどこで待っているかを測り、既存の運用と並べて検証する。Homaの価値は、AIクラスタの通信を「帯域幅」だけでなく「誰を先に通すか」という視点へ広げてくれるところにあります。

