NVIDIAは、次世代アーキテクチャを採用したプロフェッショナル向けGPUである RTX PRO 5500 Blackwell Workstation Edition を正式に発表しました。
昨今の生成AIの急速な進化や、複雑化するデジタルツイン、高度な物理シミュレーションの需要に応えるべく投入された本モデルは、エンスージアスト向けハイエンドGPUとデータセンター向けGPUのギャップを埋める重要なピースとなります。
本記事では、新たにベールを脱いだ最先端ワークステーション向けGPUの魅力や詳細なスペック、想定されるユースケースについて徹底的に解説します。
RTX PRO 5500 Blackwellの主な特徴とスペック詳細
圧倒的な大容量メモリと基本演算性能
新製品の最大の注目ポイントは、基盤に搭載されている圧倒的なメモリ容量にあります。
コンシューマー向けの最上位モデルである RTX 5090 と全く同じ21760基の CUDAコア を搭載しつつ、メモリにはエラー訂正機能を備えた ECC 対応の GDDR7メモリ を採用しています。
その容量はなんと84GBに達し、一般的な用途の枠を大きく超える仕様です。長時間の計算でもデータ化けを防ぐ高い信頼性を誇り、エンタープライズ環境での安定稼働を約束します。
ゲーミング向けRTX 5090との性能比較と違い
ベースとなるコア数は同じですが、プロフェッショナル用途に最適化されているためいくつか仕様の違いが存在します。最も大きな違いは先述したメモリ容量であり、ゲーミング用途の32GBから約2.6倍の大容量化が図られています。
一方で、メモリ帯域幅は1389GB毎秒となっており、特化したゲーミング向けモデルと比較すると帯域幅自体はやや抑えられた手堅い設計です。最大消費電力については600Wとなっており、高負荷状態が数日間にわたって続くようなシビアな環境を想定した強固な電力設計および熱設計が採用されています。
Blackwellアーキテクチャがもたらす技術的進化
第5世代Tensorコアと第4世代RTコアの実力
本製品の心臓部には、最新の Blackwell アーキテクチャが採用されています。
AIの推論や学習処理に特化した第5世代の Tensorコア は、前世代と比較して劇的な処理速度の向上を実現しており、新しいデータフォーマットにも対応しました。
また、光の反射や屈折を正確に計算する第4世代の RTコア により、建築用の3Dパースや映像制作におけるレイトレーシング処理もリアルタイムかつ極めて高精度に実行可能です。
高速なデータ転送を支えるPCIe Gen 5対応
現代の膨大なデータを扱うワークフローにおいて、マザーボードとの通信速度は非常に重要です。
本モデルは最新規格である PCIe Gen 5 に対応しており、旧世代の規格と比較して2倍の帯域幅を実現しました。これにより、巨大なデータセットをGPUのメモリへ転送する際の遅延が最小限に抑えられ、システム全体のボトルネックが大幅に解消されます。
プロフェッショナル現場を変える先進的な運用機能
マルチインスタンスGPUによるリソースの柔軟な分割
エンタープライズ向けの機能として特筆すべき点が、ハードウェアレベルでの マルチインスタンスGPU への対応です。
この技術を利用することで、単一の物理的なGPUを独立した複数の実行環境に分割することが可能になります。例えば、システム全体を利用する重いタスクがない時間帯には、42GBずつ2つの環境に分割し、複数の開発者が同時にアクセスしてテスト環境として共有するといった極めて柔軟で無駄のないリソース運用が実現します。
ラックマウント型デプロイへの最適化
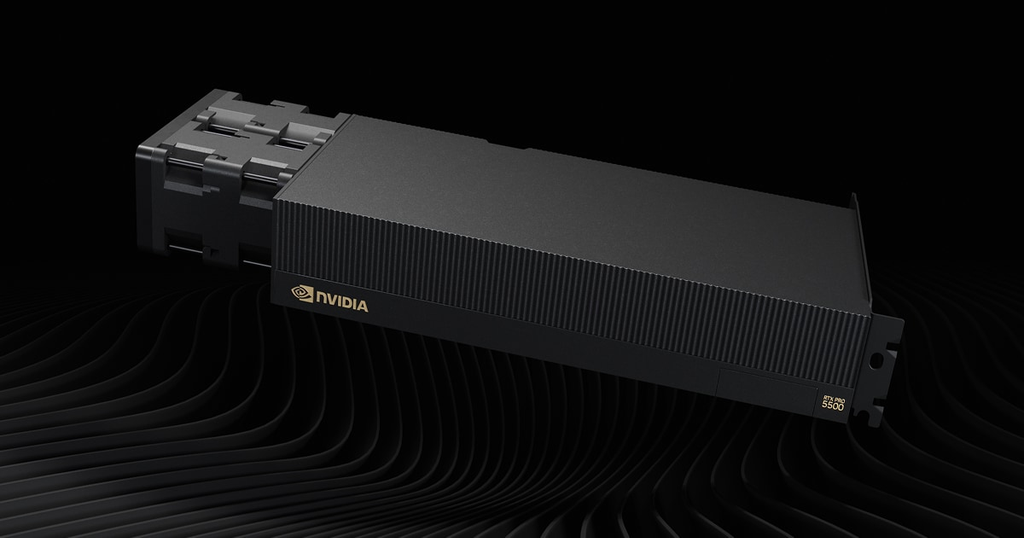
本製品は、クリエイター個人のデスクに設置するタワー型ワークステーションへの組み込みだけでなく、企業内のサーバールームに設置するラックマウント型ワークステーションへの展開も強く意識されたフォームファクタを採用しています。
限られたラックスペース内に高密度の演算リソースを集約し、社内ネットワーク越しに複数のエンジニアがその演算パワーを共有する現代的なクラウドネイティブなワークフローに最適化されています。
ラインナップにおける位置づけとターゲット層
PRO 5000とPRO 6000の隙間を埋める戦略的モデル
現在展開されているNVIDIAのプロフェッショナル向け製品群のなかで、本製品はハイエンド帯のちょうど中間に位置する絶妙な立ち位置を獲得しています。
最上位のフラッグシップモデルである RTX PRO 6000 は24064基のコアと96GBのメモリを備えていますが、その分導入コストは極めて高額になります。一方で下位モデルではメモリ容量が足りないというユーザーの声に応える、まさに痒い所に手が届く戦略的な価格対性能比を狙った製品と言えます。
大規模AIモデルおよびデジタルツインへの最適化
この84GBという広大なメモリ空間は、特にローカル環境での大規模言語モデルの開発や、エージェント型AIの自律的運用において真価を発揮します。また、工場や都市を仮想空間に再現するデジタルツイン、高解像度のテクスチャを大量に読み込む映画品質の3Dレンダリング、流体力学などの科学技術計算においても、データをメモリ内に一度に展開できる量が増加することでストレージへのスワップが発生せず、全体の処理時間が劇的に短縮されます。
発売時期と価格についての最新動向
現在、NVIDIA公式の製品ページではステータスが近日公開となっており、具体的な発売時期や販売価格についての正式な一般向けアナウンスは行われていません。
ワークステーション向け製品の常として、パートナー企業や代理店を通じた問い合わせベースでの価格提示となる可能性が高く、一般市場に広く出回るゲーミングモデルとは異なる流通経路となる見込みです。海外メディアの予測では導入にあたり計画的な予算確保が必要になることが示唆されていますが、今後のさらなる詳細な発表が待ち望まれています。
導入に向けてのまとめ
新たに発表されたこの新世代GPUは、最先端のAI開発や極めて高度なクリエイティブ作業を行うプロフェッショナルにとって、作業環境を根本から覆すゲームチェンジャーとなる可能性を秘めた強力なハードウェアです。
導入に際しては、マザーボードの対応状況や余裕のある強力な電源設備、そして確実な冷却システムなど、適切なシステム環境の構築が必要不可欠となります。しかし、それに見合うだけの圧倒的なパフォーマンスと劇的な作業効率の向上をもたらすことは疑いようがありません。今後のビジネスの成長を支える強力なインフラとして、本製品の動向から目が離せません。

